

3D版から、映像側だけを拡大する
この記事にはアフィリエイト広告が含まれます。
MiniMax H3アップスケーラー|2D版と3D版の違い
先に重要な点です。作者は2D版と3D版のノードを公開していますが、2026年8月30日に配布を確認できた3本のweightはすべて3D構成です。さらにH3の映像+音声latentはそのまま接続せず、映像と音声を分離して映像側だけを拡大し、最後に戻します。現在の配布情報では3D版から始め、2D版は対応weightを確認できた場合の選択肢です。
- 通常版(2D)
- ノード公開/対応weight未確認
- 3D版
- 縦・横・時間をまとめて処理
- 対応倍率
- 1.0〜4.0倍
- 使う前に確認
- 対応weightと入出力
現時点の結論:今すぐ試せる配布weightは3D版
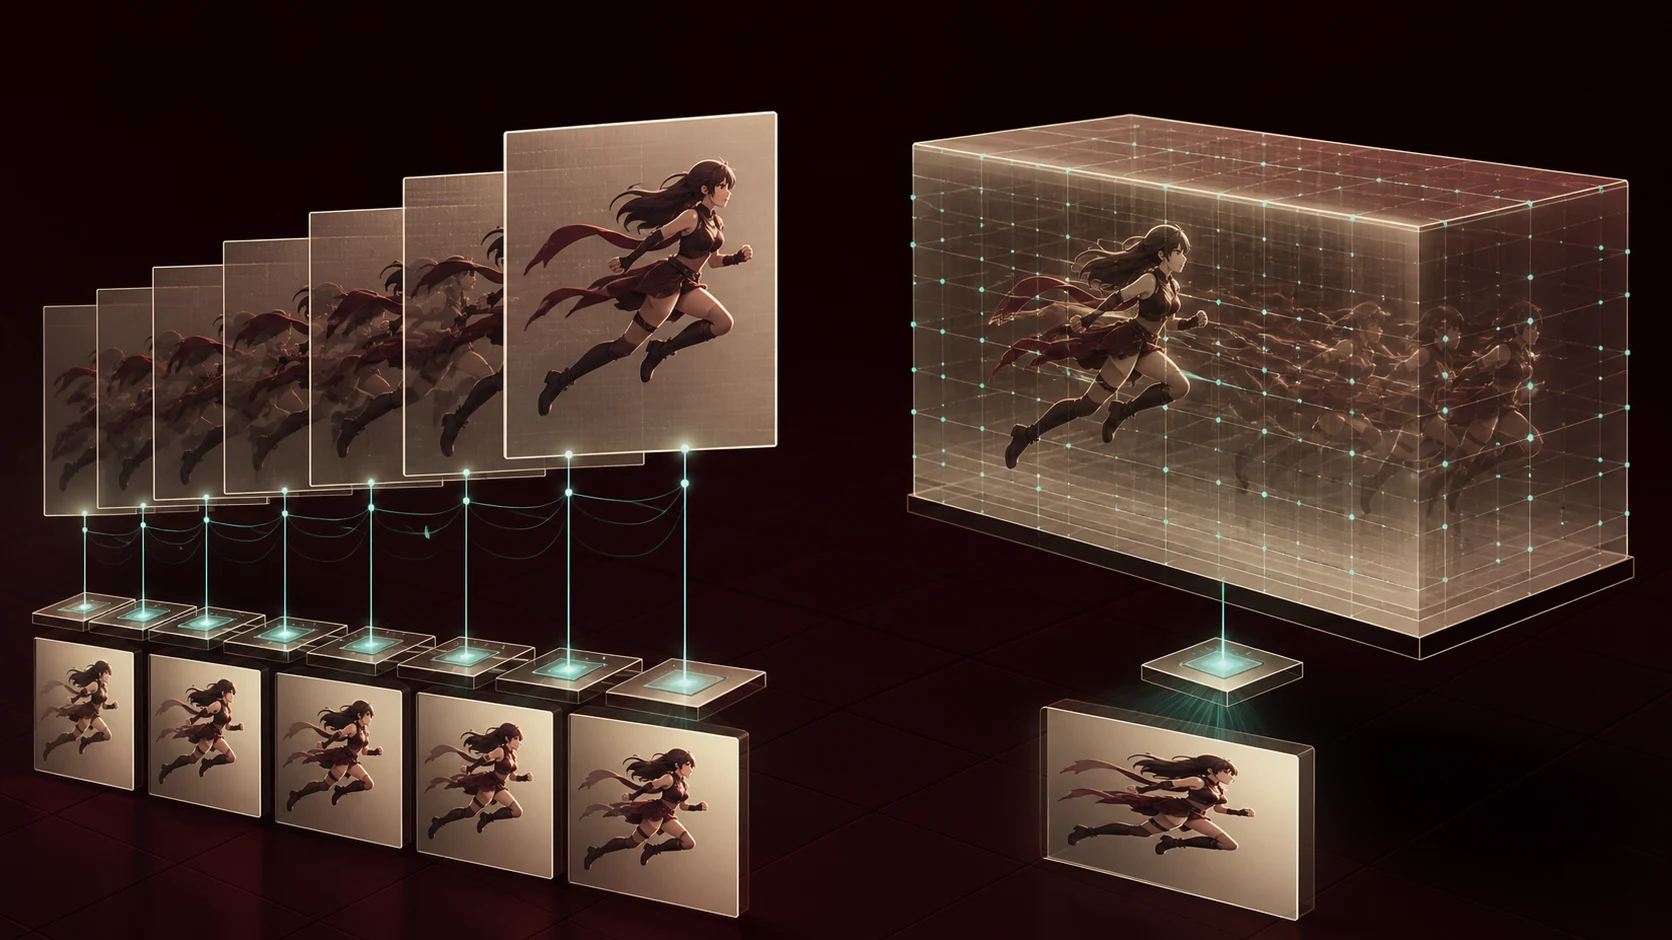
作者は2D版と3D版のノードを公開していますが、2026年8月30日にHugging Faceで確認できた配布weightは3D構成のbf16、fp16、fp32です。通常版(2D)は各フレームの縦横を主に2D処理し、途中で時間方向も確認する比較的軽い設計ですが、対応weightを確認できるまでは導入候補として断定しません。3D版は縦・横に加えて近接する時間位置を同じ計算で扱います。たとえるなら、2D版は一枚ずつ原画を仕上げながら隣のコマを確認する設計、3D版は短いフィルムを机に並べ、前後関係を見ながらまとめて描き直す設計です。
latentとは完成映像になる前の設計図
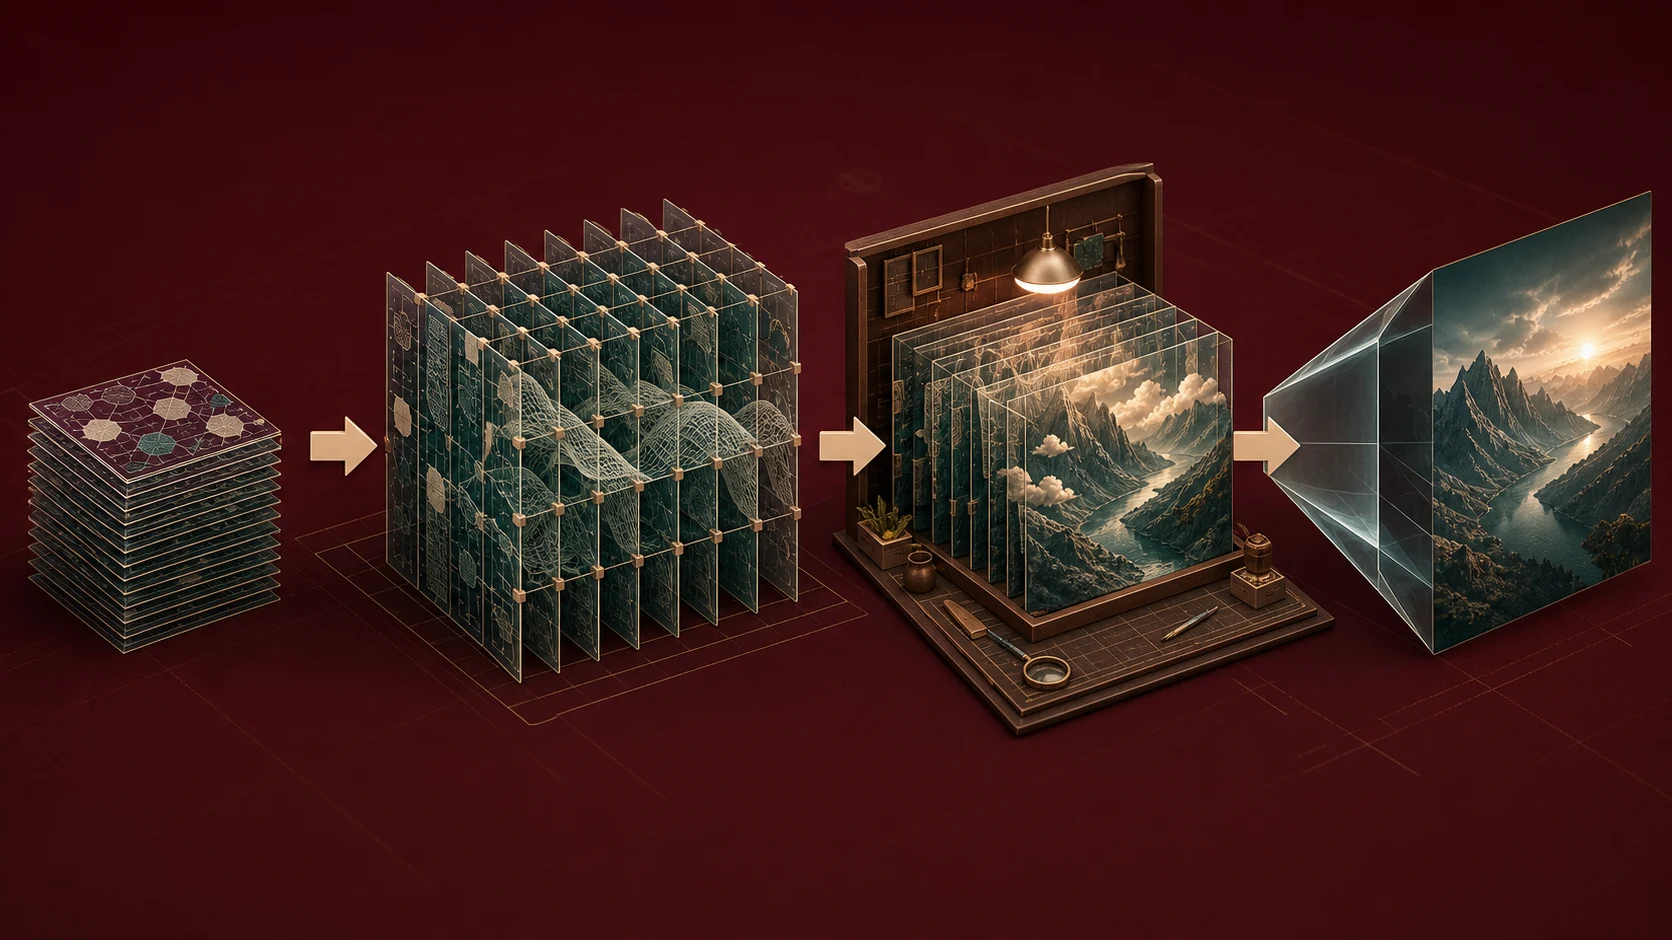
latent(潜在表現)は、目で見るRGB映像そのものではなく、形、色、質感、動きなどを圧縮して持つ内部データです。MiniMax H3のVideo VAEは映像を24チャンネルのlatentとして扱います。たとえるなら、完成した家の写真ではなく、壁、配線、材料、寸法をまとめた24冊の設計図です。Latent Upscalerは写真を引き伸ばすのではなく、この設計図を大きな建物用に描き直します。
VAEを往復しないためのアップスケーラー
VAEは完成映像とlatentを行き来させる変換器です。画素空間で拡大した後、再びlatentへ戻してrefineや再サンプリングを行う方法では、VAE DecodeとVAE Encodeの往復が必要です。完成映像を最後に画素拡大するだけなら再Encodeは不要ですが、高解像度latentで生成を続けることはできません。作者はH3のVAEを約50億パラメータ規模と説明しており、この往復を省くことを主な狙いにしています。たとえるなら、外国語の設計図を一度日本語へ翻訳し、紙を拡大してから再び外国語へ訳す代わりに、最初から外国語の設計図を直接拡張する方法です。
最重要:映像と音声のlatentを分けてから接続する
MiniMax H3の生成結果は、映像24チャンネルと音声32チャンネルを含むAV latentとして流れる構成があります。Latent UpscalerへAV latent全体を直結するのではなく、作者workflowどおりLTXVSeparateAVLatentで分離し、video_latentだけをMinimax H3 Latent Upscalerへ入れます。audio_latentはアップスケーラーを迂回させ、処理後の映像とLTXVConcatAVLatentで再結合します。たとえるなら、映像フィルムだけを拡大する機械へ音声テープまで押し込まず、別レーンで運んで出口でもう一度組み合わせる流れです。ここを省くと接続エラーや音声側の破損につながるため、2D・3Dの比較以前に守る接続条件です。
- AV latentを分ける
H3のlatentをLTXVSeparateAVLatentへ入れ、video_latentとaudio_latentへ分離します。
- 映像だけを拡大する
video_latentをMinimax H3 Latent Upscaler (3D)へ接続します。audio_latentはこのノードへ入れません。
- 映像と音声を戻す
アップスケール後の映像latentと、迂回させたaudio_latentをLTXVConcatAVLatentで再結合します。
- refineしてからdecodeする
速度優先ならそのままVAE Decode、品質優先なら目標解像度で再サンプリングまたはrefineしてからVAE Decodeします。
導入手順:現在は3D weightから始める
標準的なComfyUIでは追加依存の導入は不要と作者READMEに記載されています。ノードをcustom_nodesへ入れ、weightを専用フォルダへ置き、再起動後にvideo/MinimaxH3カテゴリから3Dノードを追加します。2026年8月30日に配布を確認できたのは3D版のbf16、fp16、fp32の3本です。2Dノードへ3D構造のweightを選ぶ前提にはしません。
- カスタムノードを入れる
ComfyUI/custom_nodes/へComfyui_Minimax_h3_latent_Upscalerを配置し、ComfyUIを再起動します。
- weightを置く
ダウンロードしたsafetensorsまたはpthをComfyUI/models/latent_upscale_models/へ置きます。
- 3Dノードを追加する
video/MinimaxH3からMinimax H3 Latent Upscaler (3D)を追加し、model_nameで置いたweightを選びます。
- 最初は2倍・align 32
modeはscale by multiplier、scaleは2.0、alignは32、enable_temporal_chunkingは有効、force_unloadは有効から始めます。precisionはGPUに合わせてbf16またはfp16を比較します。
24チャンネルの正規化は物差しをそろえる準備
2D版も3D版も、処理前に24チャンネルそれぞれの平均と標準偏差を使って値のばらつきを整え、処理後に元の尺度へ戻します。これが正規化です。たとえるなら、センチ、インチ、尺で書かれた24種類の寸法を、作業前に同じ物差しへそろえる工程です。値の大きさが違うまま計算すると、一部の特徴だけが過剰に目立ちやすくなります。
通常版(2D)は一枚ずつが中心、ただし前後も見る
通常版は時間とバッチを一度まとめ、各フレームを2DのConvとResBlockで処理してから、縦横をbilinear方式で目標サイズへ広げ、さらに学習済みの処理で補正します。途中ではデータを動画の形へ戻し、時間方向だけを見る3D Convを定期的に挟みます。たとえるなら、原画担当が一枚ずつ拡大清書し、数工程ごとに動画監督が前後のコマを見て、髪や袖の位置が飛んでいないか直す流れです。したがって、通常版を単純な一枚絵アップスケーラーと考えるのは正確ではありません。
ConvとResBlockは特徴を探して修正を重ねる
Conv(畳み込み)は、近くにある値の並びから輪郭や質感などの特徴を拾う計算です。ResBlockは元の情報を近道で残しながら、必要な修正だけを足します。たとえるなら、Convは小さな虫眼鏡を画面中で動かして模様を探す係、ResBlockは元の下絵を消さずに修正紙を重ねる校正机です。通常版は主に平面用の虫眼鏡、3D版は前後のコマまで厚みを持つ虫眼鏡を使います。
Temporal Convは各特徴の時間係
Temporal Convは、縦横を広げずlatentの時間方向だけに長いカーネルを当てます。公開コードの既定値は時間位置5個分で、チャンネルごとに変化を見た後、1×1×1の処理で情報を混ぜます。この5個は完成動画の表示フレーム数ではありません。たとえるなら、色、輪郭、布の質感を担当する各編集者が設計図上の時間カードを5枚ずつ確認し、最後に会議で修正案を統合する工程です。急なちらつきを抑える助けになりますが、元の動きを完全に修復する保証ではありません。
scale embeddingは希望倍率を作業員へ伝える指示票
モデルは拡大率から1を引いた値を小さなネットワークへ通し、ResBlockへ渡します。これがscale embeddingです。同じ修正でも1.5倍と4倍では補う量が違うため、倍率を処理へ知らせます。たとえるなら、仕立て直しの職人へ『少し広げる』のか『四倍の舞台衣装にする』のかを書いた指示票を渡す工程です。公開ノードが受け付ける倍率は1.0〜4.0倍で、縮小には使えません。
3D版は映像を時間込みの立方体として扱う
3D版はConv3Dと3D ResBlockを使い、幅W、高さH、時間Tをまとめて処理します。拡大の骨組みにはtrilinear interpolationを使い、その前後を学習済みネットワークで補正します。たとえるなら、通常版が写真アルバムの各ページを整えるのに対し、3D版は透明なコマを重ねた立体模型を彫る方法です。前後のコマを同時に見る分、時間的一貫性を狙いやすい一方、計算量とメモリ負荷は大きくなります。
trilinearは縦横を広げる仮設の足場
3D版はtrilinear interpolationを使いますが、公開コードが渡す目標サイズは時間Tを元の長さに保ち、高さHと幅Wだけを拡大します。時間方向を引き伸ばして表示フレームを増やす処理ではありません。その前後では学習済みの3D ResBlockが時間を含む特徴を読み取ります。たとえるなら、映像のページ数は変えず、各ページの用紙だけを大きくする足場を組み、前後のページを見られる職人が仕上げる工程です。
時間分割は長い巻物を重ねて作業する
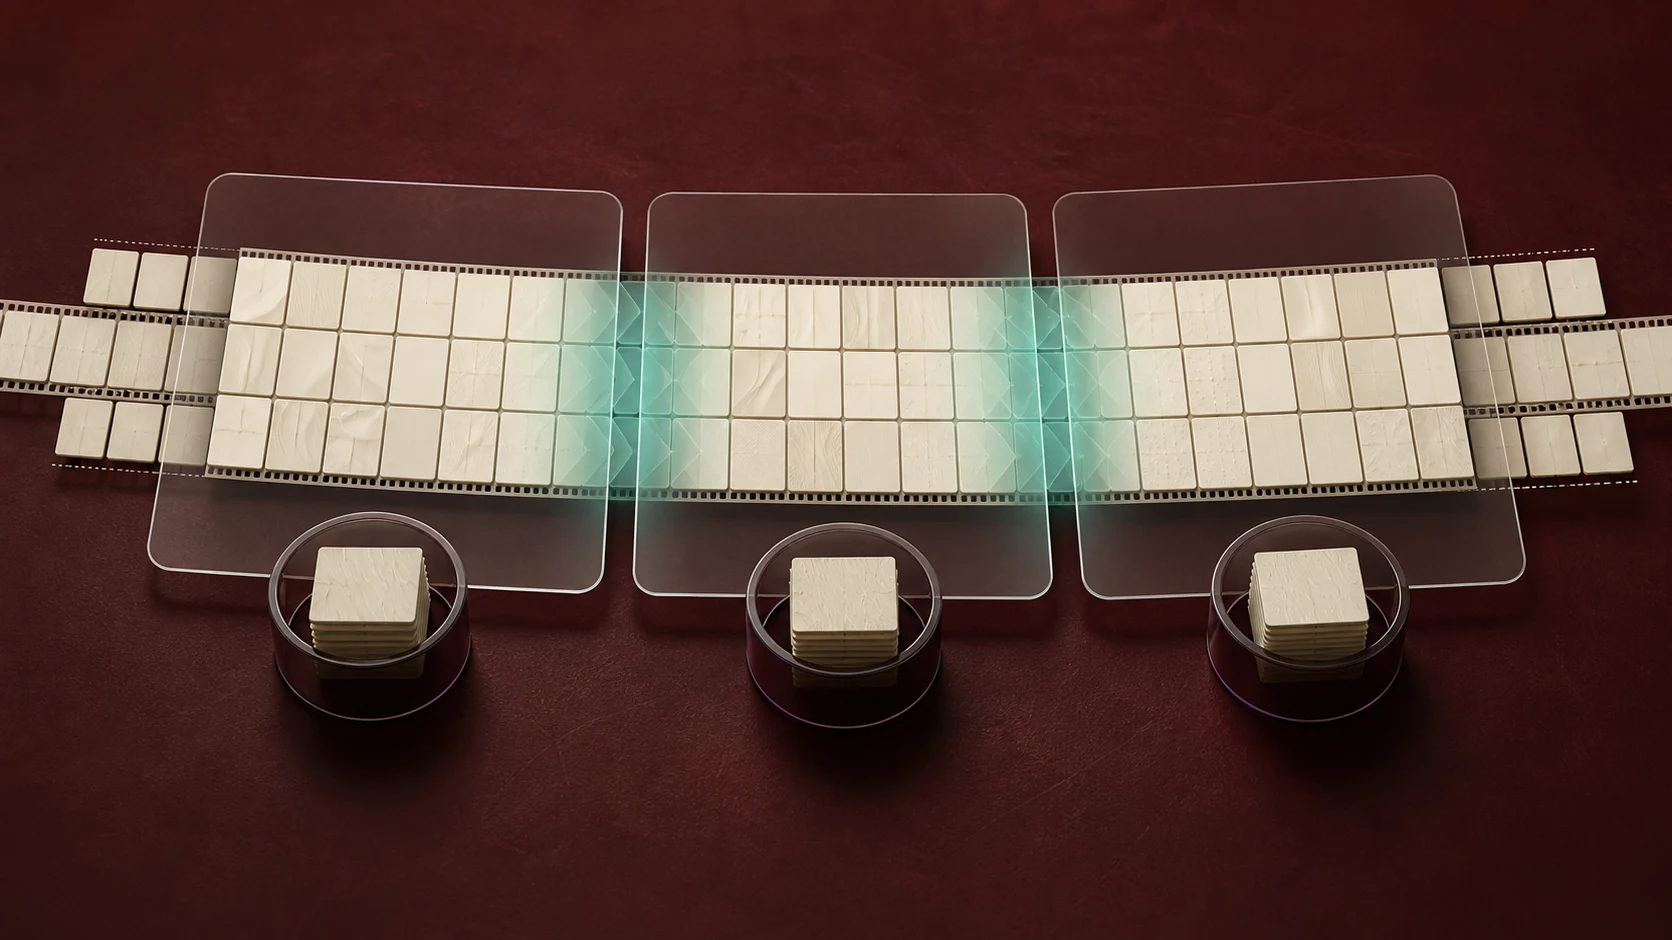
3D版は長い動画でenable_temporal_chunkingを有効にすると、既定でlatent上の時間位置32個ずつ処理します。これは完成動画の32表示フレームという意味ではありません。各区間の前後へ重なりを持たせ、端では最初または最後の時間位置を複製するreplicate paddingを使い、重なった部分は重み付きで混ぜます。たとえるなら、長い壁画を設計図上の32区画ずつ切り出し、端を少し重ねて描き、継ぎ目を薄くぼかして一枚へ戻す作業です。VRAMを抑えやすく、作者は末尾ちらつきへの対策として説明しています。作者の説明だけから、画質、速度、VRAMの優劣は決められません。
3D版は倍率・寸法・メガピクセルで大きさを決められる
3Dノードには、1.0〜4.0倍を指定するscale by multiplier、完成時の幅と高さを指定するtarget dimensions、総画素数を指定するmegapixelsの3モードがあります。たとえるなら、コピー機で『2倍』を押す方法、用紙の縦横を直接決める方法、使える紙の総面積だけを決める方法です。target dimensionsとmegapixelsでは入力との比から実効倍率を計算し、時間の長さは変えません。
align 32は仕上がり寸法をタイルへ合わせる
3Dノードは目標の画素幅と高さをalign値へ丸め、既定では32が強く推奨されています。作者は底部の光帯を避ける対策として説明しています。たとえるなら、床を31.7枚分で終わらせず、32枚単位のタイルに合う寸法へ設計し直すことです。指定した幅と高さがわずかに丸められる可能性があるため、最終サイズはノードの出力表示で確認します。
fp16・bf16・fp32は測れる範囲と目盛りの配分
precisionは数値をどの範囲まで、どの細かさで保持するかの形式です。fp16は比較的細かな目盛りを持つ一方で表せる範囲が狭く、bf16は目盛りが粗い代わりに広い範囲を扱えます。fp32は広い範囲をより細かく扱えますが、メモリと計算量が増えます。たとえるなら、同じ大きさのメモ用紙を近距離の細かな測量へ使うか、遠距離まで書けるよう桁へ配分するかの違いです。2026年8月30日に確認できた配布ファイルは、3D名のbf16とfp16が約691MB、fp32が約1.38GBです。
2Dノードと配布weightは別々に確認する
作者リポジトリには2D版と3D版のノードコードがありますが、2026年8月30日に作者のHugging Faceで確認できた3本のチェックポイントは、すべてファイル名とモデルカードが3D構成を示しています。2Dノードが公開されていることだけで、対応する2D用weightも同じ場所にあるとは断定できません。たとえるなら、2種類の再生機の設計図が公開されていても、店頭に両方の専用テープが並んでいるとは限らない状態です。導入時はノード名だけでなく、チェックポイントの構造と作者の最新配布一覧を確認します。
force unloadは作業後に机を空ける設定
3D版のforce_unloadは、処理後にアップスケーラーモデルをCPUへ戻し、後続ノードのためにGPUメモリを空ける設定です。たとえるなら、一工程を終えた職人が工具箱を倉庫へ戻し、次の職人へ作業台を譲る動きです。連続して同じノードを回す場合は再読み込みの待ち時間が増えるため、空きVRAMと反復回数を見て選びます。
速い使い方と高品質を狙う使い方は別
すぐ確認したい場合は、低解像度latentをアップスケーラーへ通し、そのままVAE Decodeします。作者が高品質向けとして勧めるのは、低解像度で生成し、latentを拡大し、目標解像度で再サンプリングまたはrefineしてからVAE Decodeする流れです。たとえるなら、設計図を拡大コピーして眺めるのが簡易確認、拡大した設計図を職人へ戻して細部を作り込むのが本仕上げです。後者は高解像度の生成を行うため、ピークVRAMまで必ず減るわけではありません。
選び方:weightを確認し、同条件で2Dと3Dを比較する
対応weightを入手でき、短い試作、すでに安定した動き、速度優先なら通常版が候補です。髪、指、服、細い輪郭など隣接する時間位置のつながりや、分割境界の安定性を重視するなら3D版を比較します。3D版も長尺全体の人物同一性を保証するものではありません。入力latent、seed、倍率、再サンプリング条件、出力解像度をそろえ、速度、最大VRAM、顔と手、輪郭のちらつき、終端、音声の有無と同期を通常速度で見ます。対応する2D用weightを確認できない場合は、ノードコードだけを理由に無理に選びません。
同じ呼び名の別実装を混ぜない
MiniMax H3のlatent upscalerには複数の作者と方式があります。LBH-123-AIの2D・3Dノード、Mamad8やTr1daeの2倍upscaler、2026年8月28日にLBHリポジトリへ追加されたMMH3 Split Upscaleは別物です。たとえるなら、同じ『急行』という看板でも路線と停車駅が違う状態です。ノード名、作者、weight、対応倍率、再サンプリング方法を一組で確認し、別実装の結果を2D版・3D版の性能として扱いません。
公式資料から確認できる範囲
2026年8月30日時点で、作者README、Hugging Faceモデルカード、2D・3Dノードの公開コードを確認できます。公開資料には、同じ入力条件で2D版と3D版を比べた画質、速度、VRAMの実測値はありません。画質、速度、VRAMの優劣は、実行するモデル、設定、入力、GPUをそろえた出力で確認してください。
よくある質問
通常版(2D)は前後のフレームをまったく見ないのですか?
いいえ。中心は各フレームの2D処理ですが、途中に時間方向の3D Convが入り、前後の変化も確認します。一枚ずつ清書しながら、定期的に動画監督が隣のコマを確認するイメージです。
3D版なら必ず通常版より高画質になりますか?
必ずではありません。3D版は時間のつながりを扱いやすい一方で重く、入力や再サンプリング条件でも結果が変わります。同じ入力、seed、倍率、出力サイズで比較してください。
アップスケーラーだけで細部まで完成しますか?
簡易確認はできますが、作者が高品質向けに示す流れは拡大後の再サンプリングまたはrefineを含みます。拡大した設計図を職人へ戻して細部を仕上げるイメージです。
アップスケーラーを使えばVRAMも必ず減りますか?
いいえ。低解像度の最初の生成とVAE往復を軽くできますが、目標解像度で再サンプリングする工程は高解像度の負荷を使います。主な狙いは時間短縮で、ピークVRAM削減とは分けて考えます。
長い動画ではtemporal chunkingを有効にしますか?
3D版では既定で有効です。latent上の時間位置32個を一区切りとして重ねて処理し、VRAMと末尾のちらつきへ対処します。完成動画の32表示フレームという意味ではありません。短い動画は無効にして全体を一度に見る比較もできます。
モデルはどこへ置きますか?
配布されたsafetensorsまたはpthをComfyUI/models/latent_upscale_models/へ置きます。2026年8月30日に確認できた配布weightは3本とも3D構造です。2Dノード用weightが同じ場所にあるとは扱わず、チェックポイント構造を確認してください。
音声付きH3 workflowへそのまま挿してよいですか?
いいえ。LTXVSeparateAVLatentで映像と音声を分け、video_latentだけをアップスケーラーへ入れます。audio_latentは迂回させ、処理後にLTXVConcatAVLatentで再結合します。
LTX用のlatent upscalerをMiniMax H3へ流用できますか?
そのままの流用は避けます。latentはモデルごとに設計図の書式が異なります。別会社の建築図面を説明なしに別の現場へ渡すようなもので、H3の24チャンネル構造に対応したものを使います。