

一枚から、衣装まで動かす
この記事にはアフィリエイト広告が含まれます。
MiniMax H3で制服AI画像を動画に|一周ターン実例とプロンプト
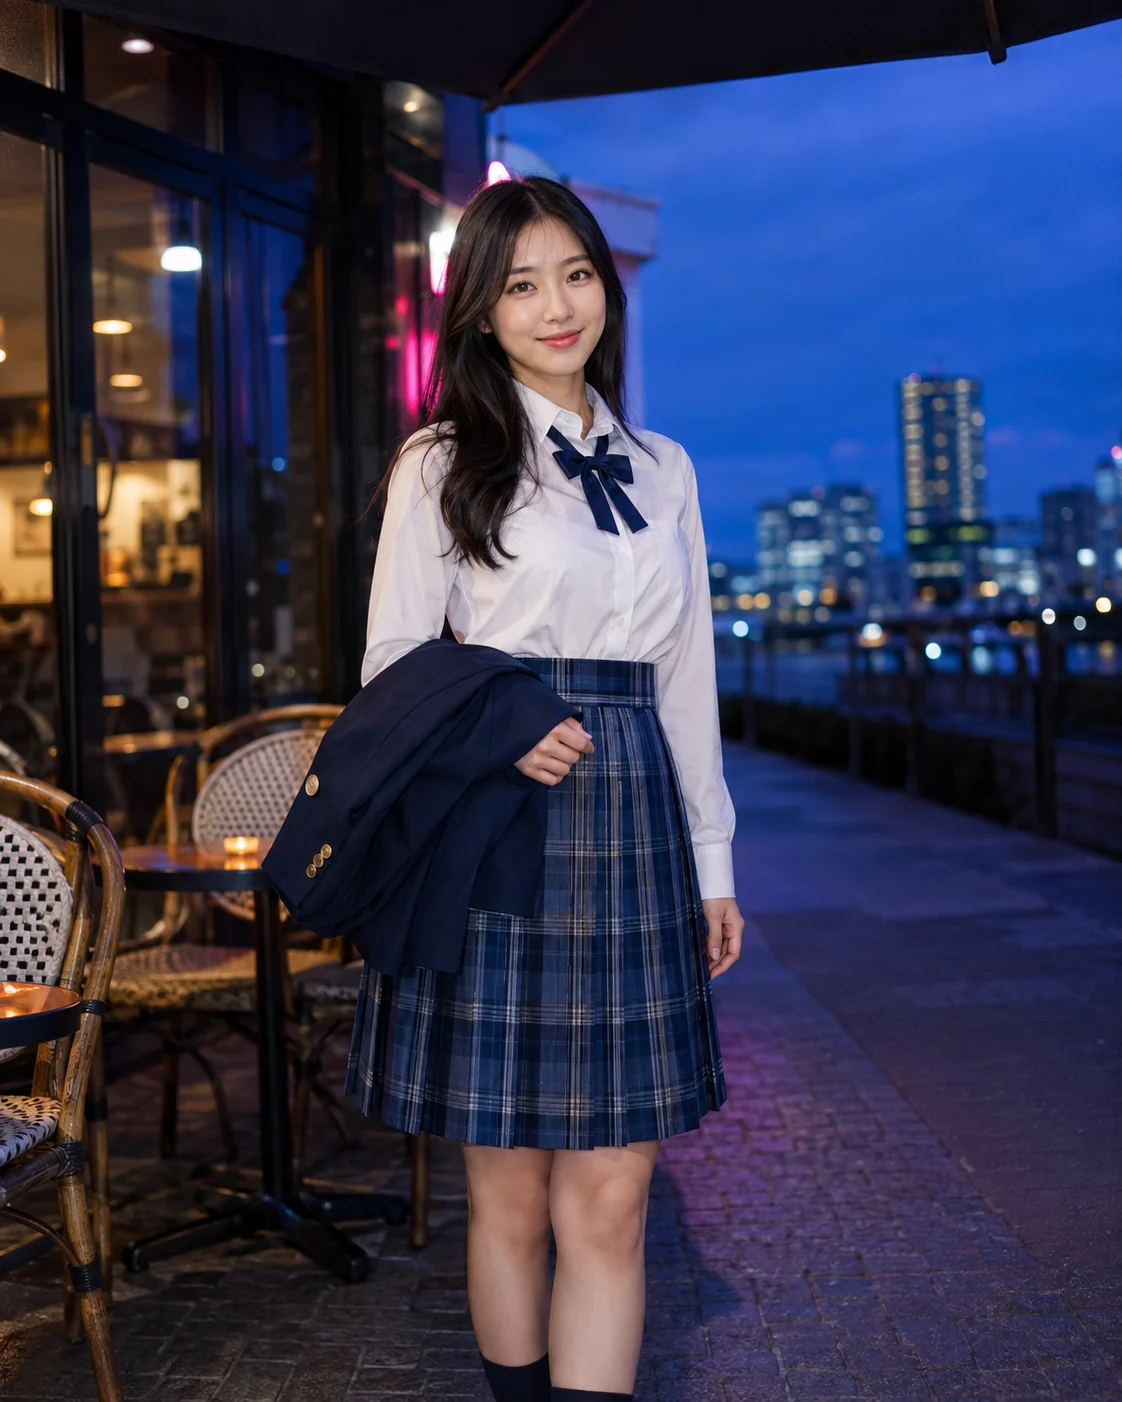
制服のAI画像で、髪やスカートの動き、衣装の前後まで見せたい。夜カフェの開始画像から、全身を見せながら一周する約10秒の動画を生成しました。完成映像のあとに、使った指示と設定を確認できます。
- 入力
- 成人コスプレのAI画像1枚
- 実際の出力
- 768×960・243コマ・24fps
- 動き
- 一歩下がって一周ターン
- 表情変化版
- 約5.17秒・124コマ
完成映像:正面から背中を通って正面へ戻る
開始画像の人物が少し下がり、正面、横、背中、反対側を通って正面へ戻ります。全身の輪郭だけでなく、向きが変わるたびに青いチェックのプリーツと長い髪がどう揺れるかを見てください。音はH3が映像と同時に生成しています。
結論:衣装を見せたいなら、衣装が変化して見える動詞を選ぶ
『かわいく立つ』だけでは、服はほとんど同じ形のままです。『一歩下がる』『一周する』『正面へ戻って止まる』のように、画面で判定できる動作へ分けます。人物の向きが変われば、スカートの前後、ジャケットの重なり、髪の流れも見せられます。料理でいえば、完成した丼の横で皿を洗うのではなく、麺を上げる一番見たい瞬間を最初に出す考え方です。
一周ターンは、中心動作を一つに絞る
この動画では、一周ターンだけを中心動作にしています。開始から約2秒で全身が入る距離へ下がり、その後に回り、最後に正面で止まる順番を指定しました。カメラを激しく回す、別の衣装へ変える、背景を移動する指示は加えていません。
表情変化だけを指示した約5秒版
同じ開始画像を使い、笑顔を少し深める指示で生成した約5秒の動画です。全身を回す約10秒版と並べると、指示する動きの違いを画面で確認できます。
使った開始画像:画面にないことを、急に足さない
元画像は夜の街のカフェに立つ、25歳の架空モデルを指定して作った成人コスプレのAIポートレートです。白いシャツ、青いチェック、腕に掛けたジャケットを引き継ぐよう指示しました。画像そのものを作ったプロンプトは、下のページにあります。
I2Vは『この画像を参考に』ではなく『ここから始めて』
I2VはImage-to-Video、画像から動画を作る方法です。画像を最初のコマとして渡す方式では、役者のプロフィール写真ではなく、撮影開始時の立ち位置を写真で渡します。人物を別の場面へ連れていく参照画像方式とは、画像の役割が違います。
一周ターンで使った設定
ComfyUI 0.34.0、RTX 5090で実行。FL2VAのINT8変換重み、QwenのNVFP4 AWQテキストエンコーダー、映像用FP16 VAEと音声用FP32 VAEを使いました。VAEは圧縮された映像や音を見聞きできる形へ戻す係、テキストエンコーダーは文章をモデルに渡す通訳です。一周版は768×960、243コマ、24fps、20 steps、seed 424242、res_multistep/simple、denoise 1、Sigma Shiftは映像12・音声3、Attentionはsage。LoRA・ControlNet・アップスケールは使っていません。seedは抽選の出発番号のようなもので、固定しても別環境での完全一致を保証するものではありません。
ComfyUIで同じ条件を組む順番
一周ターンで使用した構成です。変換版のファイル名まで揃えてください。ノードがない場合は別のノードで代用せず、使っているComfyUIと拡張の対応状況を先に確認します。
- モデルと通訳を読み込む
UNETLoader:minimax_h3_fl2va_pruned_int8_convrot.safetensors(weight_dtypeはdefault)。CLIPLoader:qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors(typeはminimax、deviceはdefault)。
- 映像と音のVAEを読み込む
VAELoaderを二つ使用。映像はminimax_h3_video_vae_fp16.safetensors、音声はminimax_h3_audio_vae_fp32.safetensorsです。
- 開始画像を接続する
LoadImageからMiniMaxH3ImageToVideoのfirst_frameへ接続。同ノードへCLIP、映像VAE、下のプロンプト、768×960、length 243を入力します。last_frameは接続しません。
- 条件をサンプラーへ渡す
モデルはMiniMaxH3SigmaShift(12/3)→MiniMaxH3PatchAttention(sage)へ。そこからBasicGuiderとBasicSchedulerへ渡します。I2VのCONDITIONINGはBasicGuider、LATENTはSamplerCustomAdvancedへ。RandomNoiseのseedは424242、KSamplerSelectはres_multistep、BasicSchedulerはsimple/20 steps/denoise 1です。
- 映像と音へ戻して保存する
SamplerCustomAdvancedのdenoised_outputをMiniMaxH3GuideSplitAVLatentへ接続。video_latentをVAEDecode、audio_latentをVAEDecodeAudioへ、それぞれ対応VAEと一緒に渡します。CreateVideoで映像・音声を24fpsとして組み、SaveVideoでMP4/H.264に保存しました。
この条件での生成時間
一周版の生成は約272秒、保存した動画は243コマで約10.13秒でした。モデルの読み込み状況、解像度、同時に動く処理によって時間は変わります。この記録だけで平均速度や必要VRAMの下限は決められません。表情変化版は124コマ、約5.17秒、生成約107.5秒でした。
次は、同じ一周でも見せる場所を変えられる
正面で始める、横向きから振り返る、歩いてから回る。中心動作を一周に保ったまま、開始姿勢や止まる位置だけを変えると、衣装のどこが最もきれいに見えるか比べられます。髪、裾、袖、手に持つ小物のうち、最も見せたいものを一つ決めてから文章を変えます。
短い動画を、どんな作品にする?
一つ動かせたら、次は『誰が、どんな場面で見たいか』を考えます。作品づくりの参考にするなら、気になる販売作品の説明やサンプルを見て、冒頭の見せ方、カットの長さ、音との合わせ方を観察してみてください。購入して確かめる場合も、映像をコピーするのではなく、構成を自分の言葉に直すのが目的です。下の広告はDMM・FANZAの成人向け作品です。H3で作られた作品だけを集めたものではありません。
COPY & CREATE
一周ターンで使った英語プロンプト
先頭画像を接続したI2V用です。文章だけの生成や、人物の参照画像として使う方式とは条件が異なります。
一歩下がり、全身で一周して正面へ戻る
約10秒の一周ターンに使用した全文です。開始画像・モデル・設定をそろえて確認してください。
よくある質問
この動画は本当に掲載画像から生成したものですか?
はい。掲載した夜カフェの画像を先頭画像として渡し、2026年9月8日にRTX 5090で生成しました。画像を拡大縮小しただけのアニメーションではありません。
同じプロンプトで必ず同じ顔になりますか?
保証はできません。元画像、モデルの変換版、seed、ソフトウェアや設定が結果に影響します。まず同じ条件を控え、変える項目を一つに絞って比較してください。
必要なVRAMはどれくらいですか?
今回は32GBのRTX 5090を使いました。生成中のピーク使用量や、低VRAM機での動作はこの実験では測っていません。32GBが最低条件という意味ではありません。